AI が答えられない要因は、2つに分かれる
生成 AI のチャットボットがうまく答えられないとき、原因は大きく2つに分かれます。「正しく答えられない」と「答えを持っていない」です。
要因 | よく起きていること | 打ち手 |
|---|---|---|
正しく答えられない(参照・手段) | 無関係な情報を参照する、すべてを生成 AI で答えている、顧客固有の情報に届かない | 参照する範囲を制御し、解決手段を使い分ける |
答えを持っていない(網羅・鮮度) | ナレッジが無い・古い、チャネルごとに内容が食い違う、現場の知見が属人化している | AI と人でナレッジを育てる |
この記事は前者を中心に扱います。後者の「答えを持ち続ける」方法は、最後の節と「ナレッジ管理の運用」の記事で紹介します。
生成 AI の誤答は、ハルシネーション(事実と違う内容をもっともらしく答えること)とも呼ばれます。参照させる範囲を絞ることは、その対策の中心になります。
参照させる範囲を、4段階で制御する
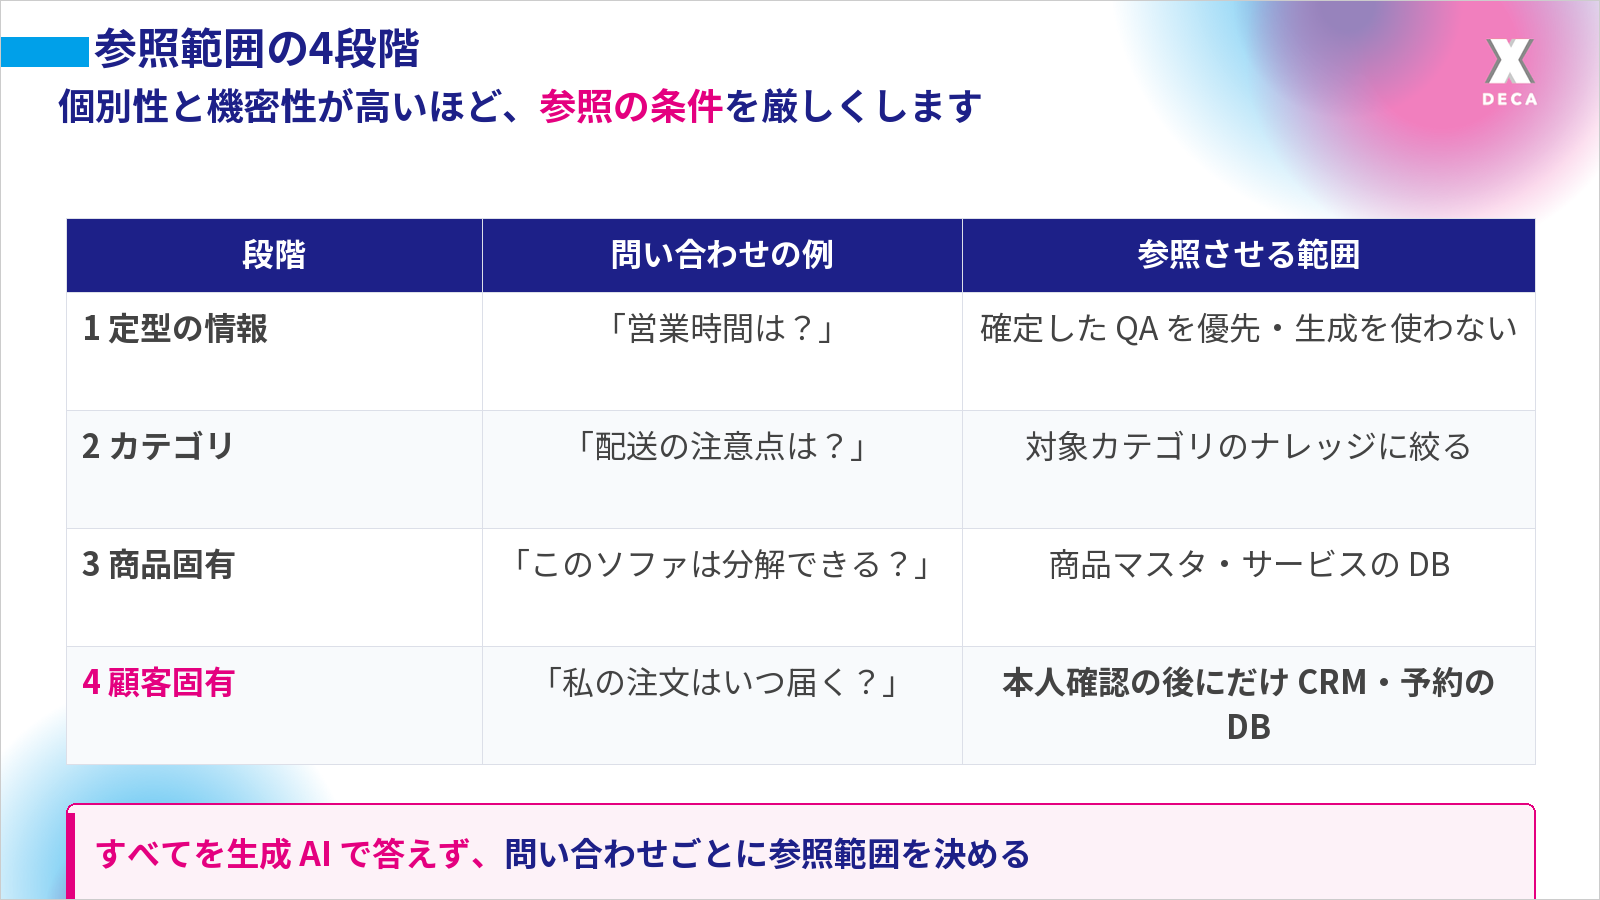
生成 AI に、手元のデータを全部読ませる必要はありません。問い合わせの個別性と機密性に応じて、参照させる範囲を段階で制御します。
<参照範囲の4段階>
段階 | 問い合わせの例 | 参照させる範囲 |
|---|---|---|
1 定型の情報 | 「営業時間は?」 | 確定した QA を優先し、生成を使わない |
2 カテゴリの質問 | 「配送の注意点は?」 | 対象カテゴリのナレッジに絞る |
3 商品・サービス固有 | 「このソファは分解できる?」 | 商品マスタ・サービスの DB |
4 顧客固有 | 「私の注文はいつ届く?」 | 本人確認の後にだけ CRM・予約の DB |
段階が上がるほど、答えはその人に固有になり、間違えたときの影響も大きくなります。段階1で生成を使わないのは、答えが決まっている質問に生成の揺れを持ち込まないためです。
この線引きは、誤った回答を防ぐだけでなく、情報漏洩のリスクを防ぐうえでも重要です。生成 AI の精度の話と、個人情報の扱いの話は、同じ設定で守ることになります。
同じ問い合わせでも、特性によって解決手段を変える
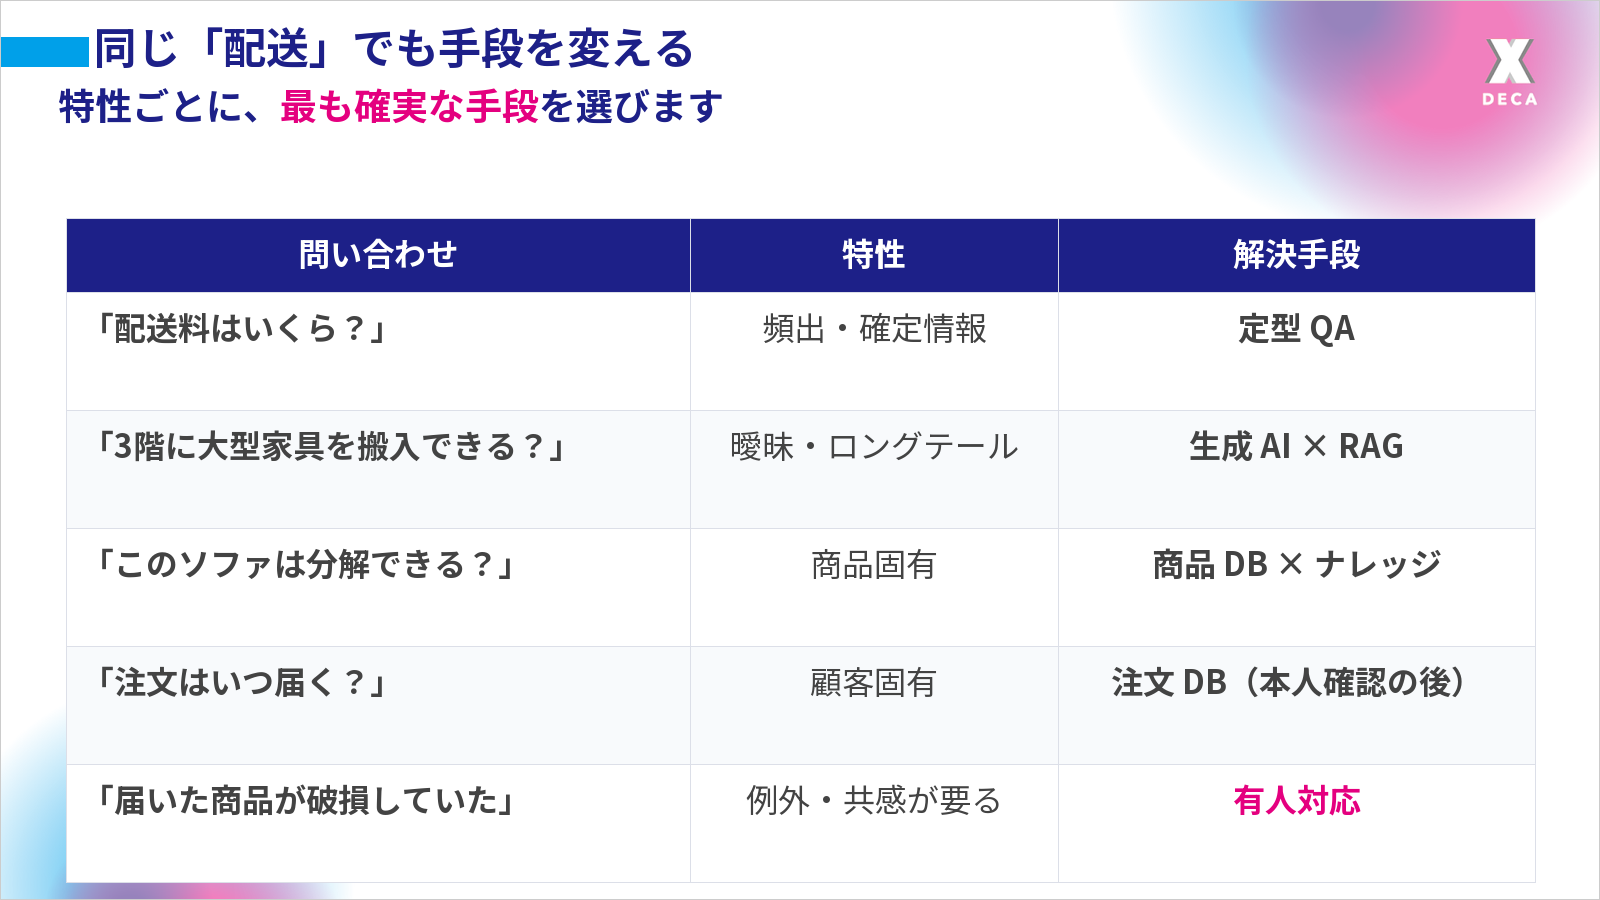
参照する範囲が決まったら、問い合わせごとに解決の手段を決めます。同じ「配送」の問い合わせでも、特性ごとに最も確実な手段を選びます。
<配送の問い合わせの解決手段>
具体例
配送についての5つの問い合わせ
「配送料はいくら?」は頻出の確定情報なので定型 QA、「マンションの3階でも大型家具を搬入できる?」は曖昧な質問なので生成 AI と RAG、「このソファは分解して搬入できる?」は商品 DB とナレッジ、「注文した商品はいつ届く?」は本人確認の後に注文 DB、「届いた商品が破損していた」は有人対応で答えます。
※ 説明のための例です(数字や設定は例示)
RAG(検索拡張生成)とは、生成 AI が答える前に手元のナレッジを検索し、見つけた内容をもとに答える仕組みです。曖昧でロングテールな質問、つまり件数は少ないが種類の多い質問に向いています。
生成 AI に任せる範囲は、定型か非定型かと誤答のリスクで決める
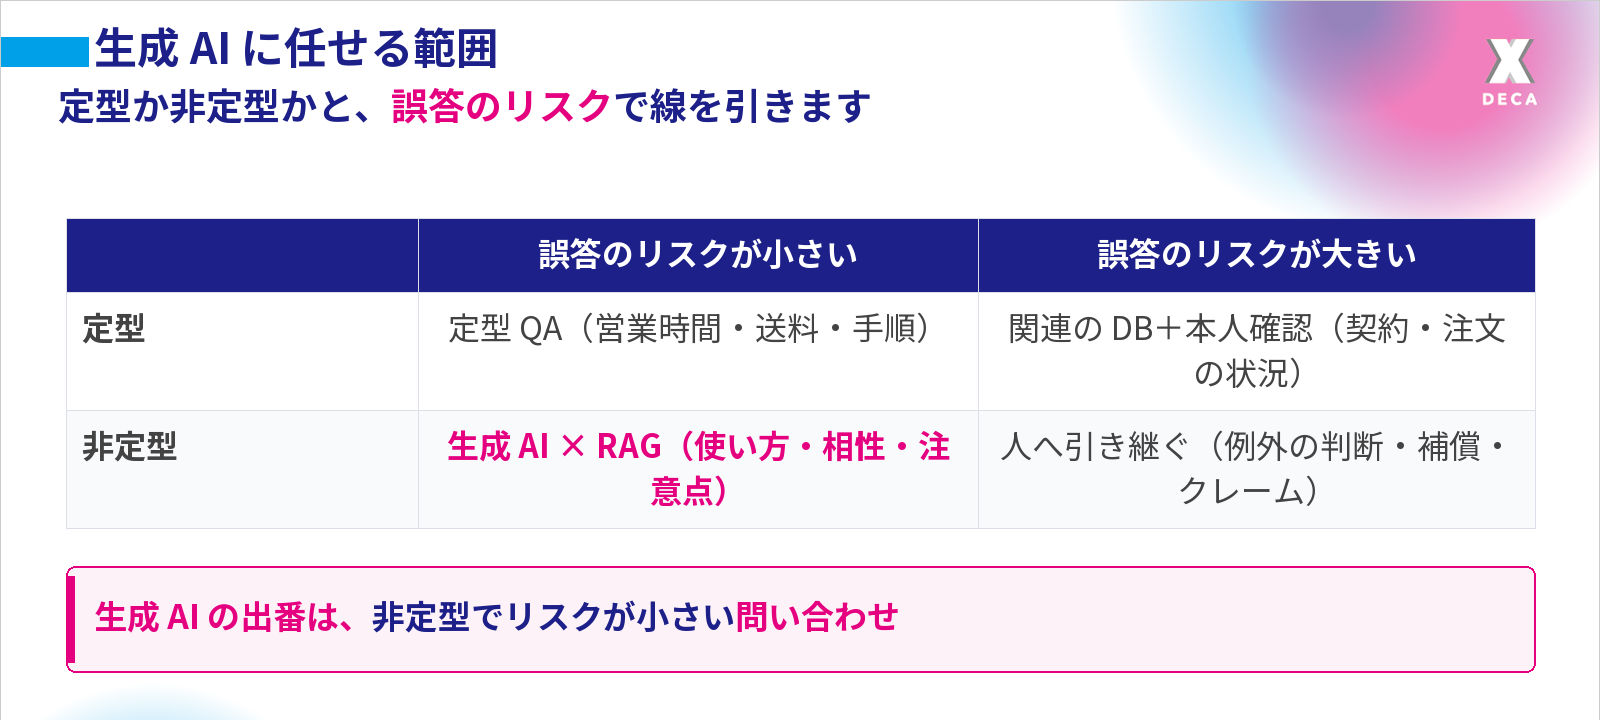
振り分けの判断を、2つの軸の表にまとめます。定型(答えが決まっている)か非定型(状況で答えが変わる)か、誤答のリスクが小さいか大きいかです。
<生成 AI に任せる範囲の決め方>
誤答のリスクが小さい | 誤答のリスクが大きい | |
|---|---|---|
定型 | 定型 QA(営業時間・送料・手順) | 関連の DB と本人確認(契約・注文の状況・ポイント残高) |
非定型 | 生成 AI と RAG(使い方・相性・注意点) | 人へ引き継ぐ(例外の判断・補償・クレーム) |
誤答のリスクの大小は、感覚で決めないようにします。万が一間違えたときに、顧客と事業にどんな損失が出るかで判断します。たとえば送料を間違えるのと、契約の状況を間違えるのとでは、損失の大きさが違います。
生成 AI と RAG に任せるのは、非定型でリスクが小さい左下のマスです。定型の問い合わせは、生成に頼らず QA か DB で答えます。非定型でリスクが大きいものは、人が答えます。
チェックリスト
任せる範囲を決めるときの確認
答えを持っていないときは、ナレッジを1か所で育てる
参照範囲と手段を決めても、参照するナレッジが無い・古いままなら、AI は答えられません。最初の節の2つ目の要因、「答えを持っていない」への打ち手です。
よく起きているのは、ナレッジが無い・古い、チャネルごとに内容が食い違う、現場の知見が属人化している、の3つです。それぞれに、打ち手があります。
起きていること | 打ち手 |
|---|---|
ナレッジが無い・古い | AI が作成・更新・整理・削除の案を出し、人が判断して承認する |
チャネルごとに食い違う | 承認したナレッジを、FAQ・チャットボット・ボイスボット・オペレーターにそろえて反映する |
似た内容が重なっていく | 追加や更新のたびに AI で既存のナレッジと照合し、統合か新規作成かを判断する |
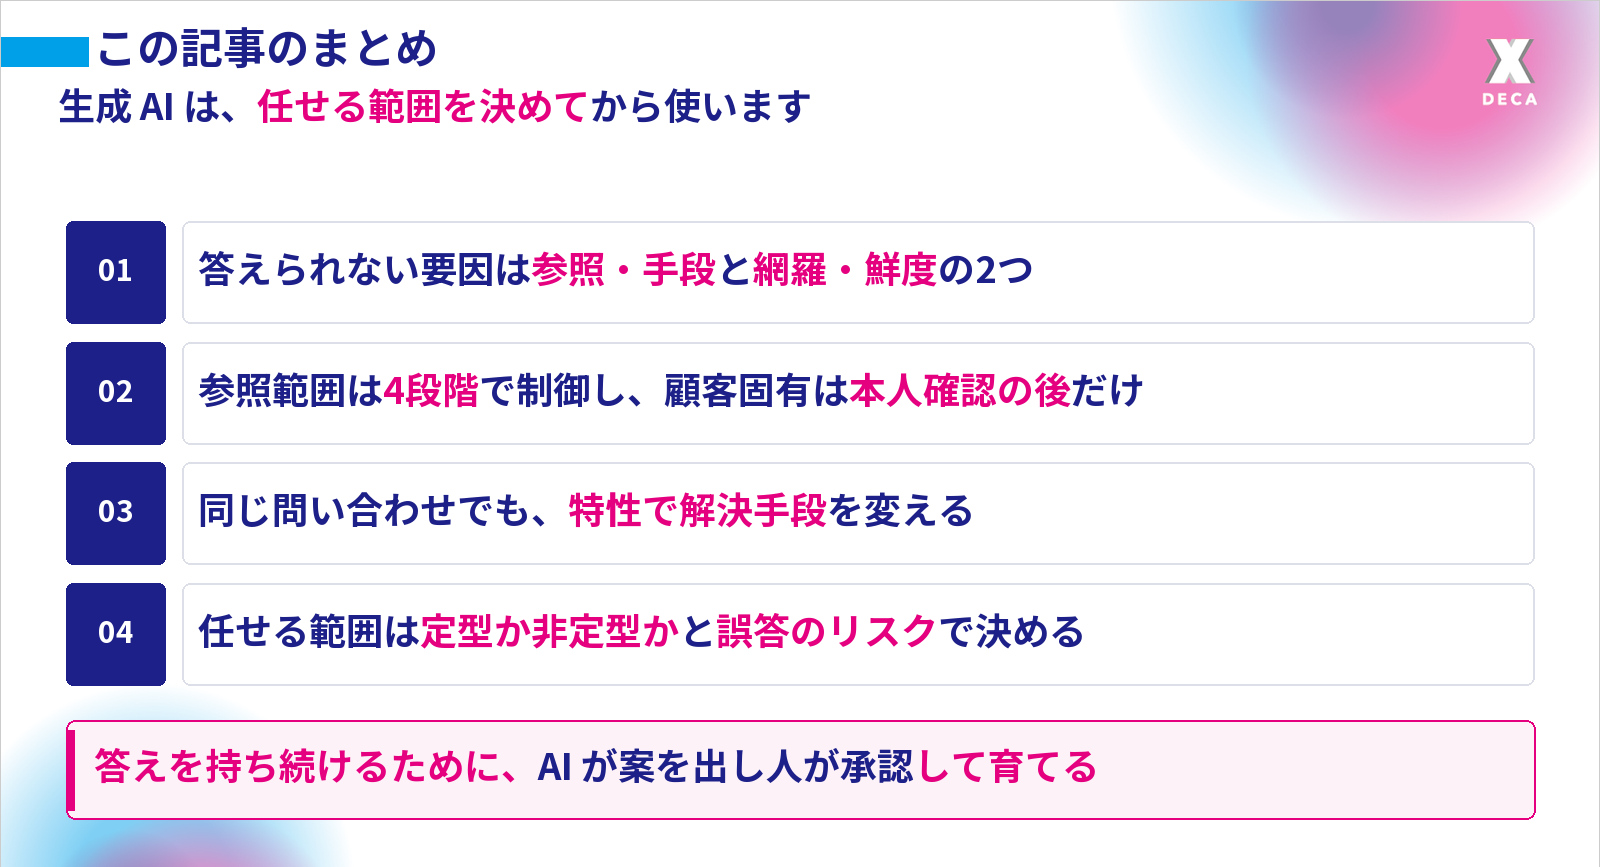
<この記事のまとめ(生成AIのカスタマーサポート活用)>
参照先の分け方も、あわせて確かめます。顧客向けと社内向けのナレッジはフォルダ単位で完全に分け、顧客向けのチャットボットは顧客向けのフォルダだけを参照させます。社内限定の判断基準が顧客への回答に混ざるのを防ぐためです。
AI は置かれたデータを忠実に参照するので、機密情報や古い版の資料は、最初からフォルダに入れません。参照範囲の制御は、フォルダに何を入れるかから始まっています。置き場所の決め方と改善の回し方は「ナレッジ管理の運用」の記事で紹介しています。
よくある質問
Qハルシネーションを防ぐには、どうすればよいですか。
すべてを生成 AI で答えず、定型の情報は確定した QA を優先して生成を使わない、カテゴリの質問は対象のナレッジに絞る、というように参照する範囲を段階で制御します。
QRAG はどんな問い合わせに向いていますか。
非定型で誤答のリスクが小さい問い合わせ(使い方・相性・注意点など)に向いています。
Qチャットボットとオペレーターで答えが食い違います。どうすればよいですか。
承認したナレッジを、FAQ・チャットボット・ボイスボット・オペレーターのすべてにそろえて反映します。チャネルごとにナレッジを持つと内容が食い違います。
Q誤答のリスクが大きいかどうかは、どう決めればよいですか。
万が一間違えたときに、顧客と事業にどんな損失が出るかで判断します。
Q注文状況のような個人の情報も、生成 AI に答えさせてよいですか。
顧客固有の質問は、本人確認の後にだけ CRM・予約の DB を参照して答えます。